



Panther Lake搭載ミニPC「GMKtec EVO-T2S」の正体と64GBメモリが選ばれる理由
Core Ultra X7 358Hが実現する次世代のAI性能
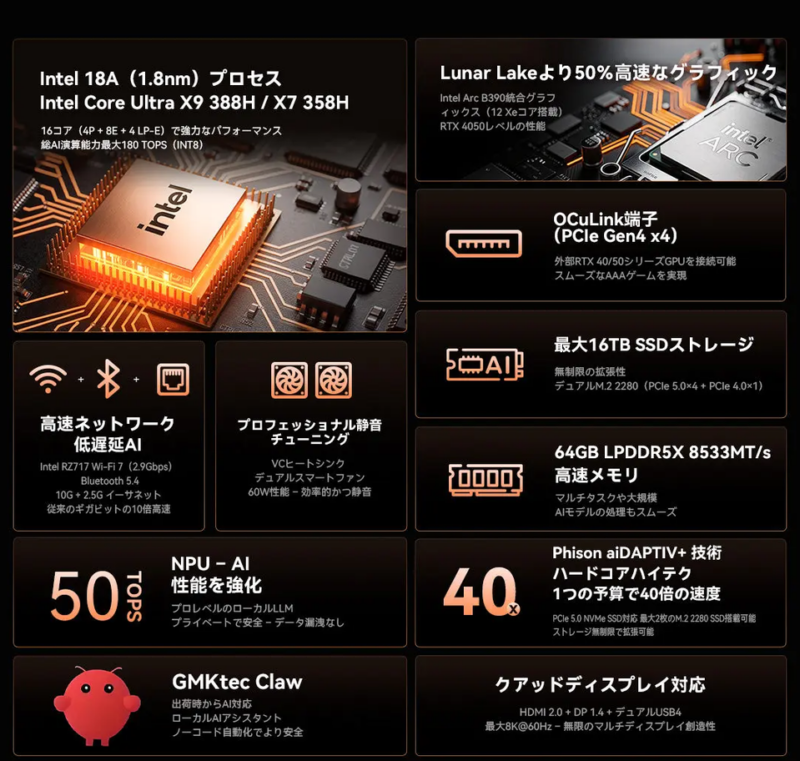
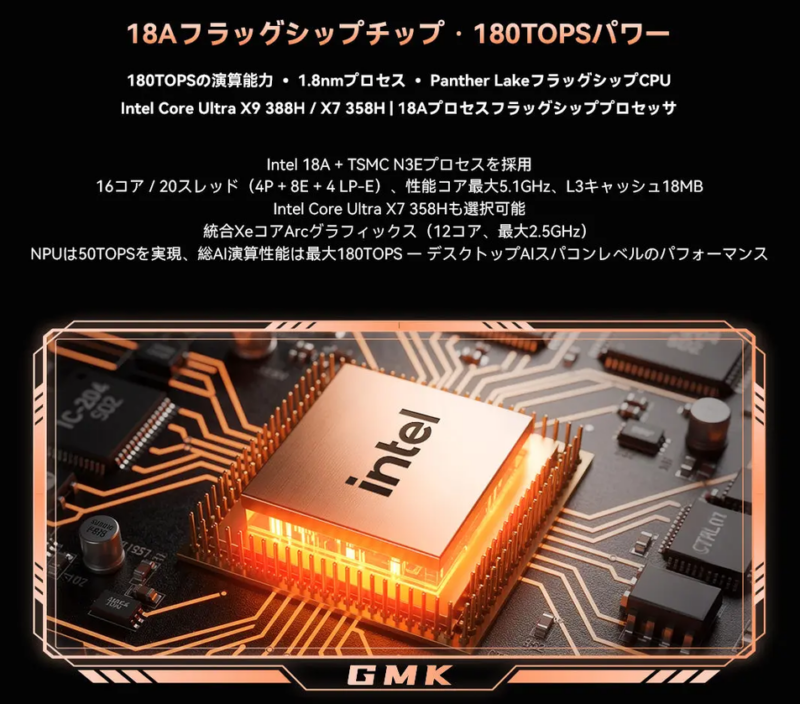
Intelの最新1.8nmプロセス「Intel 18A」で製造される次世代CPU「Core Ultra X7 358H(Panther Lake)」は、本機「GMKtec EVO-T2S」の最大のコアバリューです。
本CPUは、4つのPコア、8つのEコア、4つの低消費電力Eコアを組み合わせた計16コア/16スレッド構成となっています。最大4.8GHzで駆動し、マルチコア処理能力を大きく向上させました。
注目のAI性能においては、NPU(ニューラル・プロセッシング・ユニット)単体で最大50TOPS、GPU(Intel Arc B390)を組み合わせたシステム全体では最大180TOPSの圧倒的な演算能力に達しています。
これにより、Microsoftが提唱する「Copilot+ PC」の基準(40TOPS以上)をクリアしており、ローカル環境での高速な推論が現実のものとなりました。
モバイルノートPCの「ThinkPad X13 Gen 7」などにもPanther Lakeプロセッサーが採用され始めていますが、排熱に余裕のあるミニPCである本機は、より高い電力上限(TDP最大80W)でパフォーマンスを持続させることができます。
なぜ64GBメモリなのか?ローカルLLM運用における「VRAM割当」の重要性
ローカルLLM(大規模言語モデル)の運用において、CPUの処理速度以上に決定的な要素となるのが「メモリ容量」です。AIがローカル環境でスムーズに動作するには、数億〜数百億に及ぶモデルのパラメータデータをすべてメインメモリ(あるいはGPUのVRAM)に展開し続けなければならないためです。
一般的な16GBや32GBのメモリを搭載したPCでは、OSやシステムのバックグラウンド処理にメモリが圧迫され、AI処理用の領域が不足します。
その結果、中規模なLLMモデルをロードした時点でメモリ不足エラー(OOM)【Out Of Memory】アウトオブメモリを起こすか、動作が極めて遅くなります。
本機はLPDDR5X仕様の64GB大容量メモリを搭載しており、VRAM領域として最大48GBまで柔軟に割り当てられます。この大容量設計により、7B(70億パラメータ)や14B(140億パラメータ)クラスの中規模モデルをローカルで余裕を持って展開できるようになり、メモリ不足を回避します。
LPDDR5X-8533のメモリ帯域幅がもたらす恩恵とボトルネック(独自)
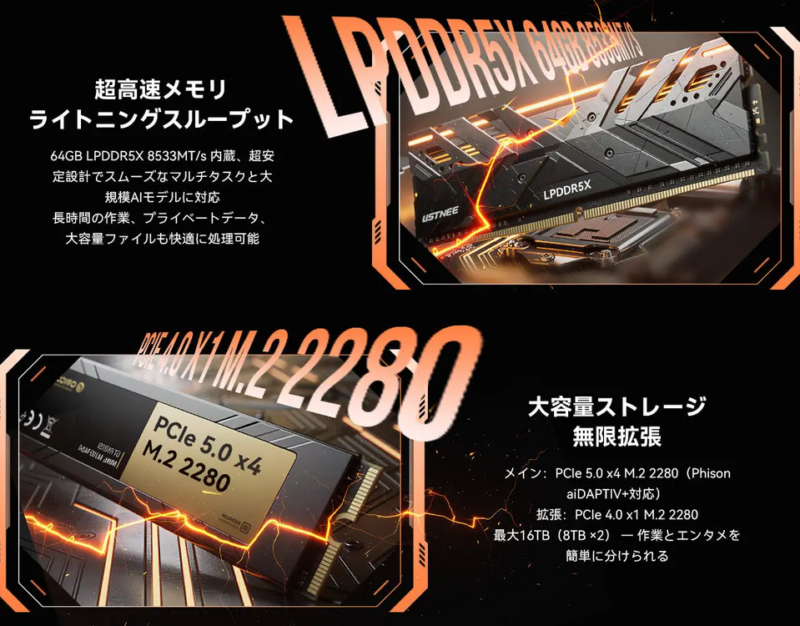
GMKtec EVO-T2Sに搭載されているメモリは、ただ容量が大きいだけではなく、最大8,533MT/sという圧倒的な転送速度を誇るLPDDR5Xが採用されています。
この超高速メモリがもたらすメリットと技術的な課題を比較したデータは以下の通りです。
| 項目 | 詳細と影響 |
| 超高速転送による恩恵(LPDDR5X-8533) | メモリ帯域幅が広がることで、AIモデルのトークン生成速度(文字の出力速度)が劇的に向上し、ストレスのないローカル会話を実現します。 |
| 統合GPUにおけるボトルネック | システムメモリを共有する仕様上、独立したVRAM(GDDR6など)を直接搭載するディスクリートGPU(dGPU)に比べると帯域幅が物理的に劣り、超大型モデル(70B以上)の処理には限界が生じます。 |
本機の高クロックメモリは一般的なミニPCを遥かに凌駕する応答性を発揮しますが、フルサイズデスクトップPC用のRTX 4090といった数GB/s〜数TB/sクラスの超広帯域を持つVRAM環境と比較すると、どうしても帯域の限界があります。
そのため、本機は「中規模モデルを効率よく、かつ低電力で運用する」という役割に最も適しています。
実機レビューで判明!EVO-T2SのローカルAI処理能力とインターフェース
買ってすぐ動く!ローカルLLMのトークン処理速度
EVO-T2Sは、AIエージェントやローカルLLMがあらかじめプリインストールされた状態で出荷されるため、複雑な環境構築をせずとも起動後すぐにAIを実行できるのが大きな強みです。
例えば、Googleが開発した中規模LLM「Gemma-4-26B」をローカル環境で動かした際、約22.25 tok/s(1秒間に約22文字)のスムーズな出力速度を記録しました。
人間が画面に表示されるテキストを読む速度よりも早いため、対話型AIとして実用レベルの快適さを提供します。クラウドAPIに依存しないため、ネットワークに接続されていないオフライン環境でも同じ速度で稼働します。
10G LAN、USB4、OCuLink搭載による圧倒的な拡張性
本機はわずか520gほどの軽量かつ超小型な筐体でありながら、デスクトップワークステーション顔負けのインターフェース構成を誇っています。
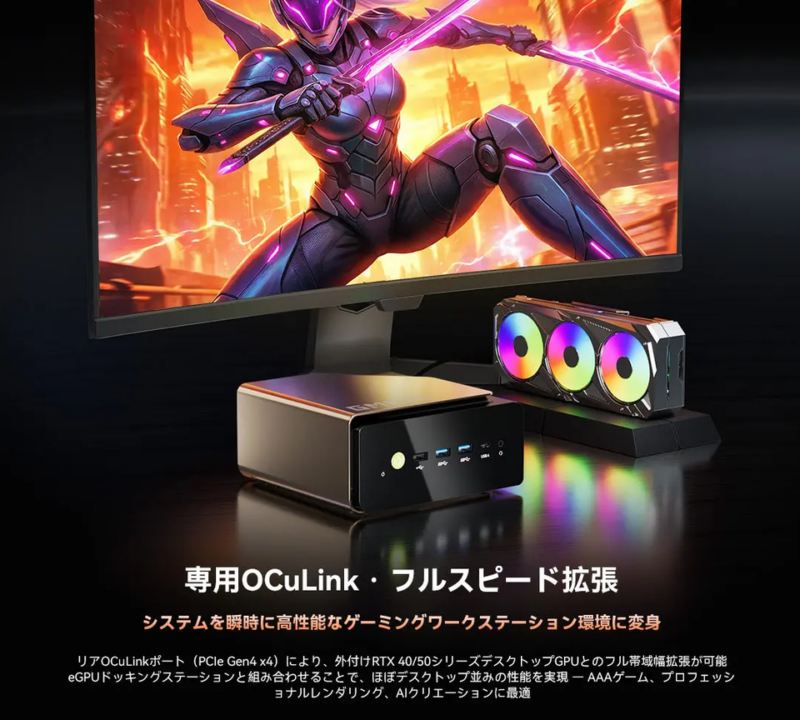
この贅沢な端子類の中でも「OCuLink」の存在は重要です。将来的にさらにグラフィック処理を強化したくなった場合、外部グラフィックボード(eGPU)を極めて低いオーバーヘッドで接続し、システム全体の演算能力を引き上げることができます。
EVO-T2Sを「ローカルAI推論サーバー」としてオフィス・自宅に構築する運用法(独自)
本機に備わっている超高速な「10G LANポート」を活用すれば、1台のデスクトップPCとして使うだけでなく、チームや家族内で共有する「ローカルAI推論サーバー(ホスト)」として運用するのが効果的です。
本機にLLM(例えばLlama 3やGemmaなど)をセットアップしてAPIサーバー化(Ollamaなどを使用)し、10G LANを通じて有線・無線接続された他のPC、スマートフォン、タブレットから推論リクエストを送信します。
こうすることで、低スペックなノートPCやモバイル端末からでも、EVO-T2Sの強力なPanther Lake NPU/GPUによる高速なAI処理の恩恵を全員で共有できます。
高価な機材だからこそ、個人のデスクで独占せず「プライベートAIサーバー」としてネットワーク共有する運用は、最もROI(投資対効果)に優れるアプローチです。
EVO-T2Sを徹底比較!Ryzen AIやMac Studioと比べて買うべきか?
競合比較!AMD Ryzen AI Max+搭載機「EVO-X2」との違い
本機の購入を検討する上で、避けて通れないライバルがAMDプラットフォームを搭載した「GMKtec EVO-X2」です。双方の特長は以下の通り明確に異なります。
- GMKtec EVO-T2S(Intel):CPUの電力効率が優れており、開発元Intelの手厚い最適化の恩恵を受けやすい。価格も比較的安価に抑えられている。
- GMKtec EVO-X2(AMD):Ryzen AI Max+ 395を搭載し、GPUの絶対的な3D/AI演算性能でIntelを凌駕する。ただし、128GBのメモリ構成モデルは3,000ドルを超えるなど、価格帯がワンランク高い。
純粋なAIの処理パワーやGPU性能を最優先するならばAMD搭載のEVO-X2が優位ですが、コストと省電力性のバランス、およびIntel製CPUならではの安定性を重視するならば、EVO-T2Sに十分な価値があります。
Apple Silicon(M4 Pro搭載Mac Studio/mini)との開発環境の違い
ローカルAI開発でトップシェアを持つApple Silicon搭載の「Mac mini」や「Mac Studio」(M4 Pro以降)とも、比較が必要です。
Macは「ユニファイドメモリ」を搭載しており、CPUとGPUが同一の極めて広い帯域幅でメモリを共有できるため、ローカルAIの処理効率においてWindowsより一枚上手とされています。
しかし、Windowsベースの本機には、独自の明確な強みがあります。
- ソフトウェア互換性の広さ:Windowsで動作する数多くのデスクトップツールや、DirectML・ONNXなどの既存ライブラリをそのまま流用可能。
- ハードウェアの自由度:Macと異なり、購入後にSSDを増設することや、OCuLink等を用いてeGPUを接続し、後からAIパワーをさらに引き上げることが可能。
一度購入すると一切のアップグレードができないMacに対し、本機は状況に合わせた段階的なハードウェアの拡張性を持っています。
「5年後の開発標準」を見据えたIntel Panther Lakeの長期的なエコシステム価値(独自)
Intelは、次世代のAI PC推進プログラムにおいて、何百万台ものPCに自社チップを普及させるべく世界中のソフトウェア開発企業(ISV)と密に提携しています。今後5年間で登場する主要なAIアプリケーションや開発者向けツール(PyTorchやOpenVINOなど)の多くは、Intel製プロセッサ、特にこの「Panther Lake」アーキテクチャに対して、最優先で最適化が進められることが予測されます。
つまり、今Panther Lakeと64GBメモリを搭載したEVO-T2Sを導入することは、数年後に業界の標準となるであろう「Intel AIエコシステム」のデファクト検証環境を、最もコンパクトな形で手元に確保することを意味します。一時的なベンチマークの数値だけでなく、開発インフラとしての寿命の長さ(将来性)が、本機の最大の隠れた価値です。
EVO-T2Sの購入を検討すべきユーザーと「後悔しない」ための判断材料
EVO-T2Sが最適なユーザーと、別の選択肢を考えるべきユーザー
高額かつ最先端の仕様を持つEVO-T2Sですが、すべての人に勧められる万能PCというわけではありません。本機をおすすめできるユーザーと、別のPCを検討すべきユーザーを以下に分類しました。
- おすすめできるユーザー
- 機密データをクラウドに送りたくない、社外秘情報を扱う企業のAI開発者
- クラウドAIの従量課金コスト(API代)を恒久的に節約したい個人クリエイターやエンジニア
- デスクスペースを極限まで広く保ちつつ、ローカルAIワークステーションを構築したい人
- 別のPCを検討すべきユーザー
- 最新のAAAゲームを最高画質・高フレームレートで楽しみたいゲーマー(RTX 50シリーズ等を搭載した「Legion 5a Gen 11」などの本格ゲーミングPCやノートPCの方が快適です)
- Web閲覧やオフィスソフト、動画視聴などのライトユースが中心の人(ここまでのスペックはオーバースペックです)
デスクスペースを美しく保つためにコンパクトなキーボードを合わせるなら、「KF86 MAX」のようなタッチパッド内蔵折りたたみキーボードを選択すると、よりスッキリとしたAI作業環境が完成します。
約33万〜38万円という価格に対する「長期的な資産価値」の評価
EVO-T2Sは、実売で約33万円〜38万円と、ミニPCとしては非常に高額な部類に入ります。しかし、この価格設定が本当に割高であるかは、クラウドAIとの対比でシミュレーションする必要があります。
毎日1万〜2万トークン以上の膨大なやり取り(コード生成やテキスト推論など)をクラウドAPI(GPT-4クラスなど)経由で行うエンジニアの場合、月々のAPI使用料が数万円に達することも珍しくありません。
本機を導入し、中規模モデル(GemmaやLlama)で日々の開発検証をローカル完結させれば、クラウドのトークンコストを最大70%削減できるため、1年〜1年半前後で本体価格の差額を十分に回収できます。
また、Intel 18Aという最先端プロセスで設計されたCPUや64GBの超高速メモリは、今後3〜5年間は現役のハイエンド機として前線で戦える十分な性能を維持できます。
分解と内部アクセスから探るメンテナンス性とパーツの資産寿命(独自)
「ミニPCは使い捨て」という印象を抱く人も多いですが、GMKtec EVO-T2Sは底面カバーを外すことで内部パーツに極めてアクセスしやすい親切な設計になっています。
CPUやメモリ、さらにシステムを急冷させるための強力な冷却機構(ベイパーチャンバー構造など)の内部清掃がユーザー自身の手で容易に行えます。
AI処理はCPU・GPUに継続して高い負荷(TDP最大80Wなど)をかけるため、内部にホコリが溜まると熱ダレ(サーマルスロットリング)を起こし、動作性能が低下します。
定期的にファンを取り外して清掃できること、そしてM.2 SSDスロットが2基あり、将来的にSSDの寿命(TBW)が尽きた際や容量が足りなくなった際に自分で素早く交換・増設ができる設計は、PCとしての製品寿命そのものを大幅に伸ばしてくれます。高額な投資だからこそ、この物理的な「メンテナンス性」と「パーツ交換の容易さ」が長期にわたる確かな資産価値を担保してくれます。
まとめ:GMKtec EVO-T2SはローカルAI開発を革新するコンパクトな最適解
本記事では、GMKtec EVO-T2Sの驚異的なAI処理能力から、なぜ64GBメモリが必要なのかという技術的背景、そして競合プラットフォームとの明確な違いまで網羅的に解説しました。
最新のIntel 18Aプロセスを採用した「Panther Lake」は、システム全体で最大180TOPSという極めて強力な処理性能を持ち、大容量の64GB高速メモリを組み合わせることで、GemmaやLlamaといった主要な中規模LLMモデルをサクサクとローカル上で動作させます。
実売で約33万〜38万円という価格は一般的なミニPCとしては確かに高額ですが、日々の高額なクラウドAPI代を最大70%削減できる回収効率や、今後数年間にわたりIntelが進めるAIエコシステムのデファクト検証環境がデスクに手に入るメリットを考えれば、価格以上のメリットを持つ長期的な開発資産になります。
機密情報を扱うオフィスから個人の秘密基地まで、セキュアかつ快適なローカルAI運用を実現する最良の1台として、導入を検討してみてはいかがでしょうか。
だんごでした。